Übung 11 - Anwendung I: Gruppenvergleiche & ANOVA
FS 2026
Wiederholung & Vertiefung: Gruppenvergleiche & ANOVA
Die ANOVA fragt: Wie viel der gesamten Streuung in den Daten lässt sich durch Gruppenzugehörigkeit erklären?
Varianzzerlegung
Jede Beobachtung setzt sich zusammen aus einem Gruppeneffekt und einer individuellen Abweichung davon. Formal:
- SS_total = SS_between + SS_within
- F = MS_between / MS_within
F ist gross, wenn die Gruppen weit auseinanderliegen (MS_between gross) und die Streuung innerhalb der Gruppen gering ist (MS_within klein). F = 8 bedeutet: Die Varianz zwischen den Gruppen ist achtmal grösser als die Varianz innerhalb.
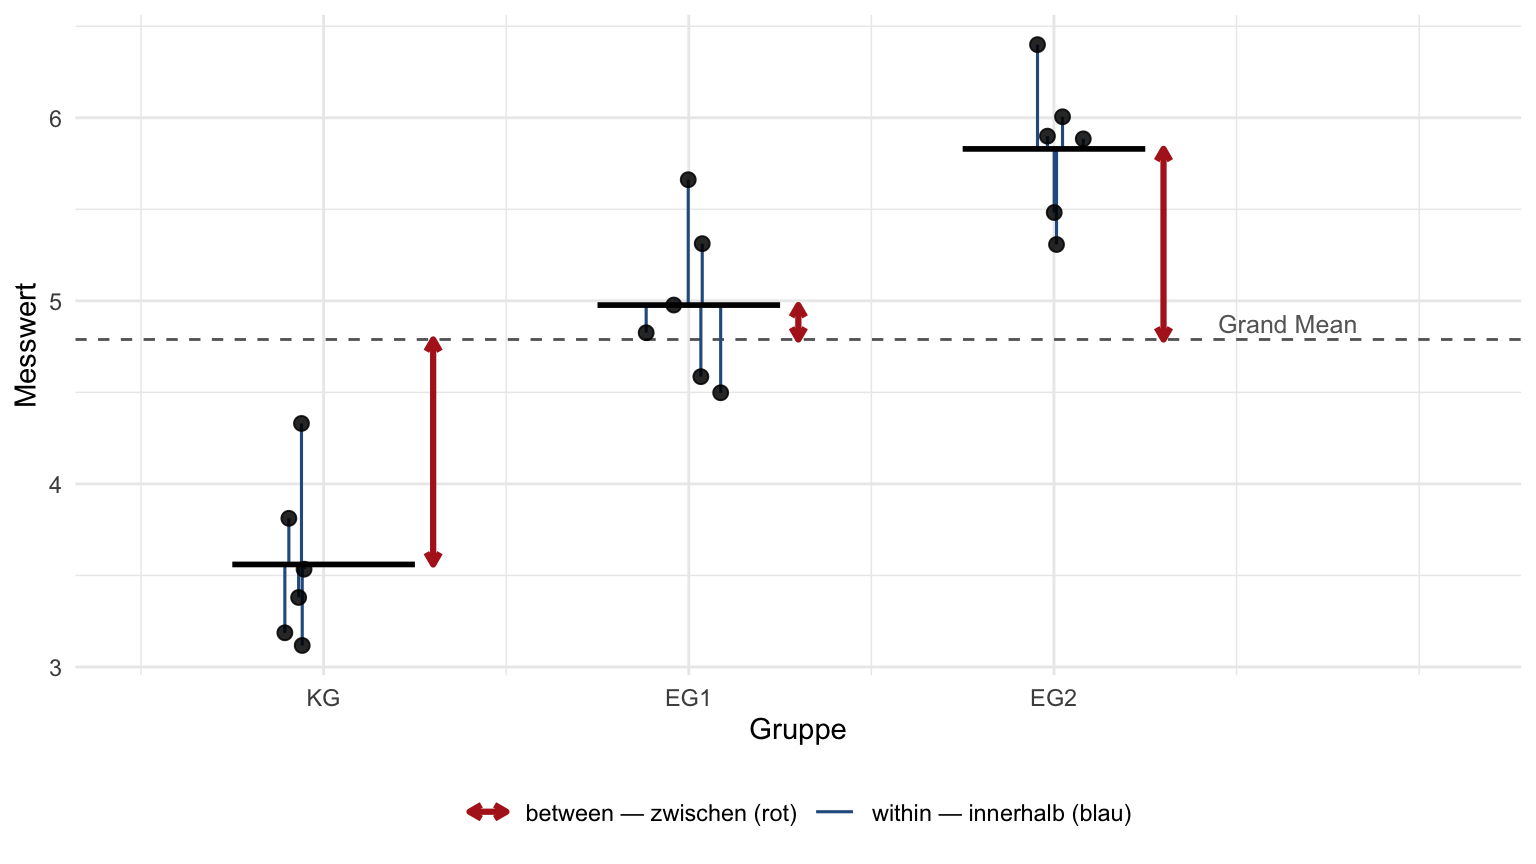
Die Abbildung unten zeigt das geometrisch: Blaue Segmente = Abstand jedes Punkts zum Gruppenmittelwert (within). Rote Pfeile = Abstand des Gruppenmittelwerts zum Gesamtmittelwert (between).
Das Modell rechnen: afex
library(afex)
modell <- aov_ez(id = "id", dv = "wm_score_t2",
                 between = "gruppe", data = wm_daten)

print(modell)        # Ergebnistabelle mit Effektgrösse (ges)
nice(modell, es = "pes")  # alternativ: partial η²
Der Output von print() hat vier Kernspalten: df (Zähler/Nenner), MSE (mittlere Fehlervarianz, Nenner der F-Statistik), F und ges (generalisiertes η²). Bei einfaktoriellen Between-Designs entspricht ges dem klassischen η² aus Statistik 2.
Signifikanz ≠ Relevanz
| Kennwert | Aussage |
|---|---|
| p-Wert | Wie wahrscheinlich wäre dieses Ergebnis unter H₀? |
| η² (ges/pes) | Anteil erklärter Varianz — die Effektgrösse |
| Cohen’s d | Standardisierter Mittelwertsunterschied (zwei Gruppen) |
Ein kleines p bei grossem N kann einen winzigen Effekt signifikant machen. Deshalb: Immer Effektgrösse berichten.
Richtwerte für η² (aus der Formelsammlung):
| η² | Effekt |
|---|---|
| ≈ .01 | klein |
| ≈ .06 | mittel |
| ≈ .14 | gross |
η² = .13 liegt zwischen .06 und .14 — das ist ein mittlerer bis grosser Effekt. Werte zwischen den Schwellen werden entsprechend eingeordnet.
Annahmen prüfen
library(performance)
check_model(modell, check = c("normality", "qq", "homogeneity"))
check_homogeneity(modell) # Levene-Test als Zahl| Annahme | Prüfung | Bei Verletzung |
|---|---|---|
| Normalverteilung der Residuen | QQ-Plot + Dichteplot via check_model(check = c("normality", "qq")) |
Kruskal-Wallis (bei kleinem n und starker Verletzung) |
| Varianzhomogenität | Homogeneity-Panel via check_model(check = "homogeneity"); ergänzend check_homogeneity(modell) für Levene’s Test |
Welch-Test: oneway.test(..., var.equal = FALSE) |
| Unabhängigkeit | Studiendesign — nicht durch Plot prüfbar | Anderes Modell (Messwiederholung, hierarchisch) |
ANOVA ist robust gegenüber moderaten Normabweichungen, wenn n ≥ 30 und die Gruppen ähnlich gross sind.
Post-hoc-Vergleiche
Die ANOVA sagt: irgendwo gibt es einen Unterschied. Sie sagt nicht wo. Bei mehr als zwei Gruppen braucht man Post-hoc-Tests.
library(emmeans)
emm <- emmeans(modell, ~ gruppe)
pairs(emm, adjust = "tukey")
Tukey ist Standard bei ANOVA mit mehreren Gruppen. Bonferroni ist konservativer und passt besser bei wenigen, gezielten Vergleichen. Der Output zeigt für jedes Gruppenpaar: estimate (Mittelwertsdifferenz), SE, t.ratio und das adjustierte p.value.
Übungen
Beantworten Sie die folgenden Fragen zu Gruppenvergleichen und ANOVA.
Bevor Sie die ANOVA berichten, prüfen Sie die Modellannahmen visuell mit check_model():
library(afex)
library(performance)

modell <- aov_ez(id = "id", dv = "wm_score_t2",
                 between = "gruppe", data = wm_daten)
check_model(modell)
In der Vorlesung haben wir uns bei check_model() auf zwei zentrale Diagnoseplots konzentriert:
- QQ-Plot der Residuen (Annahme: Normalverteilung der Residuen): Die Punkte liegen nahe an der Referenzlinie, keine systematische Abweichung in den Enden.
- Homogeneity of Variance (Test auf non-constant variances): Die Linie verläuft annähernd waagerecht; die Streuung der Residuen ist über die Gruppen hinweg vergleichbar.
Die beiden Gruppen haben vergleichbare Gruppengrössen (n_KG ≈ n_Stress ≈ 50).
Was ist die angemessenste Schlussfolgerung?
In der Vorlesung haben wir bei check_model() zwei zentrale Plots besprochen: den QQ-Plot für die Annahme der Normalverteilung der Residuen und den Homogeneity-of-Variance-Plot für den Test auf non-constant variances (das visuelle Pendant zum Levene-Test). Liegen die Punkte im QQ-Plot nahe an der Referenzlinie und verläuft die Linie im Varianzplot annähernd waagerecht, sind die zentralen ANOVA-Annahmen erfüllt und die Analyse kann wie geplant berichtet werden. Falsch sind: Eine zusätzliche formelle Testung mit Shapiro-Wilk oder Bartlett ist nicht erforderlich (bei grossem N werden diese Tests tendenziell immer signifikant, bei kleinem N findet keiner etwas — die visuelle Diagnose ist deshalb informativer); eine Datentransformation wäre ein unverhältnismässiger Eingriff ohne klare Rechtfertigung; und check_model() ist in diesem Kurs explizit als Entscheidungsgrundlage konzipiert.
In einer hypothetischen Studie (nicht dem Stress-WM-Projekt) wurden drei experimentelle Bedingungen verglichen: eine Experimentalgruppe (EG), eine Kontrollgruppe (KG) und eine Wartekontrollgruppe (WG). Eine einfaktorielle ANOVA ergab einen signifikanten Gruppenunterschied (F(2, 97) = 4.91, p = .009).
Die ANOVA sagt: Irgendwo unterscheiden sich die Gruppen — sie sagt aber nicht welche. Sie führen daher Post-hoc-Vergleiche mit Bonferroni-Korrektur durch:
emm_gruppe <- emmeans(anova_ergebnis, . ~ gruppe)
pairs(emm_gruppe, adjust = "bonferroni")
contrast estimate SE df t.ratio p.value
EG - KG 6.9 2.41 97 2.86 0.015
EG - WG 2.1 2.38 97 0.88 1.000
KG - WG -4.8 2.44 97 -1.97 0.156Welche Aussagen sind korrekt?
Die ANOVA zeigt nur, dass irgendwo ein Gruppenunterschied existiert — Post-hoc-Vergleiche mit Bonferroni- oder Tukey-Korrektur identifizieren, welche Gruppen sich unterscheiden (siehe Vorlesung). Die Bonferroni-Korrektur passt die p-Werte nach oben an, um die Alpha-Fehler-Kumulierung bei mehreren Tests zu kontrollieren — ohne diese Korrektur würde die Wahrscheinlichkeit eines falsch-positiven Befundes mit jedem zusätzlichen Vergleich steigen. Aus der Tabelle ergibt sich, dass nur EG vs. KG signifikant unterschiedlich ist (p = .015, geschätzte Differenz 6.9 Punkte). Falsch ist: Dass nicht alle paarweisen Vergleiche signifikant sind, ist normal — eine signifikante ANOVA wird dadurch nicht entkräftet.
Sie führen eine ANOVA mit afex::aov_ez() für Projektfrage Q1 durch und erhalten folgenden Output:
library(afex)
modell <- aov_ez(id = "id", dv = "wm_score_t2",
                 between = "gruppe", data = wm_daten)
modell
Anova Table (Type 3 tests)
Response: wm_score_t2
Effect df MSE F ges p.value
1 gruppe 1, 98 156.2 8.42 ** .079 .004
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '+' 0.1 ' ' 1Welche Aussagen zur Interpretation dieses Outputs im Sinne der Varianzzerlegung (Daten = Modell + Fehler) sind korrekt?
Die Varianzzerlegung der ANOVA folgt der Logik Daten = Modell + Fehler: ges (generalisiertes η²) ist der Anteil der Varianz, der durch das Modell (die Gruppenzugehörigkeit) erklärt wird — hier rund 8 %. MSE = 156.2 ist die mittlere Varianz innerhalb der Gruppen und steht im Nenner der F-Statistik (F = MS_between / MS_within); sie repräsentiert den unerklärten Fehleranteil. Die Richtung des Effekts ist dem Output nicht direkt zu entnehmen, dafür sind deskriptive Kennwerte oder Post-hoc-Vergleiche nötig. Falsch ist hingegen die Aussage, der p-Wert mache eine separate Effektgrösse überflüssig: Signifikanz ≠ Relevanz — bei grossem N können auch kleine Effekte signifikant werden, deshalb sollte η² immer berichtet werden.