Übung 12 - Anwendung II: Regression & Vorhersagen
FS 2026
Wiederholung & Vertiefung: Regression & Vorhersagen
In dieser Übung beschäftigen wir uns mit der linearen Regression als Verallgemeinerung des Gruppenvergleichs. ANOVA und Regression sind Spezialfälle desselben linearen Modells.
Das lineare Modell
y = b₀ + b₁·x + e
| Koeffizient | Bedeutung |
|---|---|
| b₀ (Achsenabschnitt) | Vorhergesagter y-Wert bei x = 0 |
| b₁ (Steigung) | Veränderung in y pro Einheit x |
| e (Fehler) | Nicht erklärte Abweichung |
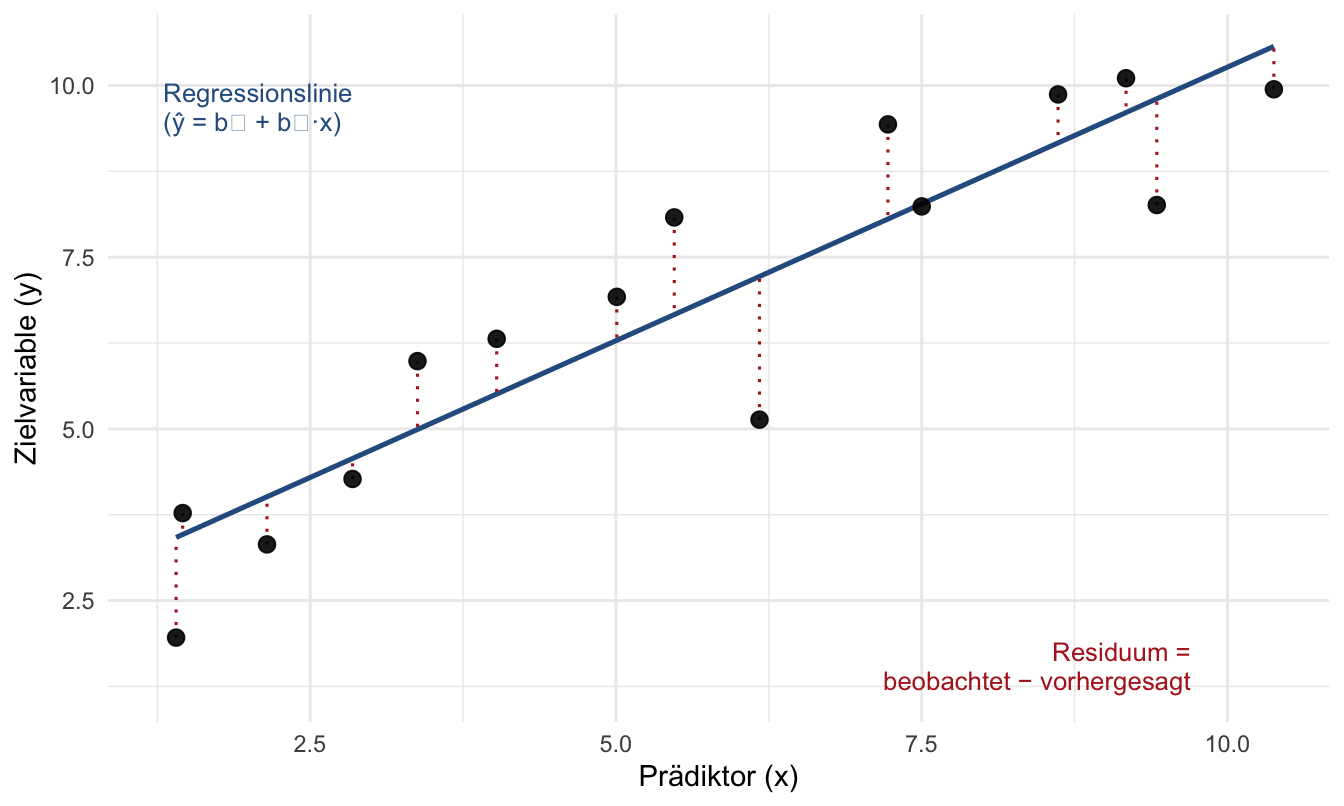
Der Fehler e lässt sich geometrisch zeigen: Für jeden Datenpunkt ist das Residuum der senkrechte Abstand zwischen dem beobachteten Wert und der Regressionslinie (dem vorhergesagten Wert). Die Regression wählt die Linie so, dass die Summe der quadrierten Residuen minimal wird (“Kleinste-Quadrate-Schätzung”). Das Verständnis dieser Abstände ist zentral für die spätere Modellprüfung in Aufgabe 9.
summary(lm()) lesen
Der Output von summary() enthält zwei Kernsektionen:
Koeffizienten-Tabelle — eine Zeile pro Prädiktor:
| Spalte | Bedeutung |
|---|---|
Estimate |
Geschätzter Koeffizient b — Veränderung in y pro Einheit x |
Std. Error |
Unsicherheit der Schätzung (nicht die SD der Variable!) |
t value |
= Estimate / Std. Error |
Pr(>|t|) |
p-Wert für H₀: b = 0 |
Modellgüte — unterhalb der Koeffizienten:
Multiple R-squared: Anteil erklärter Varianz — in der Psychologie oft .05–.30Adjusted R-squared: korrigiert R² für die Anzahl Prädiktoren — steigt nur, wenn ein Prädiktor echten Erklärungswert liefert (R² hingegen steigt immer, auch bei uninformativen Variablen)- F-Statistik: prüft das Gesamtmodell (alle Prädiktoren zusammen)
Konfidenzintervalle für Koeffizienten liefert confint(modell).
Vom Differenzmodell zur ANCOVA
Projektfrage Q2 fragt nach der Veränderung im WM-Score. Die intuitive Umsetzung: Differenzscore berechnen und vorhersagen.
wm_daten$wm_delta <- wm_daten$wm_score_t2 - wm_daten$wm_score_t1
lm(wm_delta ~ sleep_hours_t2 + gruppe, data = wm_daten)
Mathematisch ist das äquivalent zu einem Modell, in dem der Baseline-Koeffizient fix auf 1 gesetzt ist. Die Kovarianzanalyse (ANCOVA) lässt diesen Koeffizienten von den Daten schätzen:
lm(wm_score_t2 ~ wm_score_t1 + sleep_hours_t2 + gruppe, data = wm_daten)Wegen Regression zur Mitte liegt der tatsächliche Baseline-Koeffizient meist unter 1 (z.B. 0.6). Die ANCOVA nutzt diese Information → mehr statistische Power als das Differenzmodell.
Modellvergleich mit anova()
R² steigt immer, wenn Prädiktoren hinzukommen — auch bei inhaltlich irrelevanten Variablen. Deshalb braucht es einen formalen F-Test:
modell1 <- lm(wm_score_t2 ~ sleep_hours_t2, data = wm_daten)
modell2 <- lm(wm_score_t2 ~ sleep_hours_t2 + wm_score_t1 + gruppe, data = wm_daten)
anova(modell1, modell2)
Der Output zeigt in der letzten Spalte (Pr(>F)), ob der Varianz-Zuwachs grösser ist als zufällig zu erwarten. Voraussetzung: Die Modelle müssen ineinandergeschachtelt sein und auf dem gleichen Datensatz (gleiches N) basieren.
Interaktion und Simple Slopes
Projektfrage Q3 fragt, ob der Schlaf-Effekt in KG und Stressgruppe gleich stark ist. Das prüft ein Interaktionsterm:
lm(wm_score_t2 ~ wm_score_t1 + sleep_hours_t2 * gruppe, data = wm_daten)sleep * gruppe ist eine Abkürzung für sleep + gruppe + sleep:gruppe. Im Output bedeuten die drei Terme:
| Term | Bedeutung |
|---|---|
sleep_hours_t2 |
Schlaf-Effekt in der Referenzgruppe (KG) |
gruppeStress |
Intercept-Differenz Stress vs. KG bei Schlaf = 0 |
sleep_hours_t2:gruppeStress |
Differenz der Steigungen — das ist der Interaktionsterm |
ImportantReferenzgruppe in R
R wählt die Referenzgruppe automatisch alphabetisch (bzw. die erste Faktorstufe). Bei gruppe mit Werten "KG" und "Stress" ist "KG" die Referenz. Die Haupteffekte im Koeffizientenoutput beziehen sich immer auf diese Referenzgruppe — nicht auf den Durchschnitt aller Gruppen.
Häufige Fehlinterpretation: Haupteffekte im Interaktionsmodell sind konditional auf die Referenzgruppe — nicht gemittelt über alle Gruppen.
Simple Slopes (Steigung pro Gruppe mit KI und p-Wert) liefert emmeans::emtrends():
emtrends(modell, pairwise ~ gruppe, var = "sleep_hours_t2")Für die Visualisierung: marginaleffects::plot_predictions() zeigt die Vorhersagen aus dem tatsächlichen ANCOVA-Modell. geom_smooth(method = "lm") würde dagegen ein neues Modell ohne Baseline-Kontrolle fitten — was ein verzerrtes Bild ergibt.
plot_predictions(modell, condition = c("sleep_hours_t2", "gruppe"))Centering: Koeffizienten interpretierbar machen
Im Modell ohne Centering ist der Intercept der WM-Score bei Schlaf = 0 Stunden — inhaltlich sinnlos. Im Interaktionsmodell ist der Schlaf-Haupteffekt nur der Effekt in der Referenzgruppe. Centering löst beide Probleme:
wm_daten$sleep_c <- wm_daten$sleep_hours_t2 - mean(wm_daten$sleep_hours_t2, na.rm = TRUE)| Was ändert sich | Was bleibt gleich |
|---|---|
| Intercept (= Wert bei durchschnittlichem Schlaf) | Interaktionskoeffizient |
| Haupteffekte im Interaktionsmodell | Steigungen, R², p-Wert des Modells |
ImportantCentering verändert den Interaktionskoeffizienten nicht
Der Interaktionsterm (sleep_hours_t2:gruppeStress) bleibt durch Zentrierung invariant — er misst die Differenz der Steigungen zwischen den Gruppen, und die Steigungen ändern sich durch eine Verschiebung der Skala nicht. Centering verändert nur den Intercept und die Haupteffekte der zentrierten Variablen.
Annahmen prüfen
Dieselbe Funktion wie bei der ANOVA — weil es dasselbe lineare Modell ist:
library(performance)
check_model(modell)| Annahme | Diagnostik-Plot |
|---|---|
| Linearität | Residuen vs. Fitted |
| Homoskedastizität | Scale-Location-Plot |
| Normalverteilung der Residuen | QQ-Plot |
| Einflusspunkte | Influence-Plot (Cook’s Distance) |
| Kollinearität (bei mehreren Prädiktoren) | VIF-Plot |
Reproduzierbarer Regressions-Workflow
- Modell bauen mit
lm() - Erweitern und vergleichen mit
anova() - Interaktionen spezifizieren mit
* - Centering für interpretierbare Haupteffekte
- Simple Slopes via
emtrends() - Annahmen via
check_model()
Übungen
Beantworten Sie die folgenden Fragen zu Regression und Vorhersagen.
Sie vergleichen ein einfaches und ein ANCOVA-artiges Regressionsmodell, um Projektfrage Q2 auch mit Baseline-Kontrolle zu beantworten:
modell1 <- lm(wm_score_t2 ~ sleep_hours_t2, data = wm_daten)
modell2 <- lm(wm_score_t2 ~ sleep_hours_t2 + wm_score_t1 + gruppe,
              data = wm_daten)
modell1 hat R² = .081, modell2 hat R² = .152. Sie führen einen formalen Modellvergleich durch:
anova(modell1, modell2)Analysis of Variance Table
Model 1: wm_score_t2 ~ sleep_hours_t2
Model 2: wm_score_t2 ~ sleep_hours_t2 + wm_score_t1 + gruppe
Res.Df RSS Df Sum of Sq F Pr(>F)
1 98 13392
2 96 11672 2 1720.0 7.07 .001 **Was lässt sich aus diesem Vergleich schliessen?
Der Modellvergleich mit anova() zeigt, dass die zusätzlich erklärte Varianz durch die Baseline-WM (wm_score_t1) und die Gruppenzugehörigkeit (gruppe) statistisch signifikant ist (p = .001). R² stieg von 8.1% auf 15.2% — die zusätzlichen Prädiktoren tragen substanziell zur Vorhersage bei. Wichtig: R² steigt grundsätzlich immer bei mehr Prädiktoren, auch bei irrelevanten Variablen — deshalb braucht es den formalen Modellvergleich. Falsch ist: Dass R² = .152 „niedrig” sei, ist kein Grund, das Modell zu verwerfen. In der Psychologie sind solche Werte üblich, und die Modellwahl sollte sich am signifikanten Modellvergleich orientieren, nicht an einer willkürlichen R²-Schwelle.
Sie rechnen ein Interaktionsmodell für Projektfrage Q3 („Moderiert Stress den Schlaf-Effekt?“) und erhalten folgenden Output:
modell <- lm(wm_score_t2 ~ sleep_hours_t2 * gruppe + wm_score_t1,
             data = wm_daten)
summary(modell)
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 13.45 6.12 2.20 .030 *
sleep_hours_t2 2.02 0.55 3.67 <.001 ***
gruppeStress 4.18 3.28 1.27 .207
wm_score_t1 0.61 0.09 6.78 <.001 ***
sleep_hours_t2:gruppeStress -0.52 0.41 -1.27 .208Welche Aussage zur Interpretation des Interaktionsterms sleep_hours_t2:gruppeStress ist korrekt?
Der Interaktionsterm sleep_hours_t2:gruppeStress testet, ob sich die Steigung des Schlaf-Effekts zwischen KG und Stressgruppe unterscheidet. Bei p = .208 ist dieser Unterschied nicht signifikant — der Schlaf-Effekt ist in beiden Gruppen vergleichbar. Falsch ist: sleep_hours_t2 = 2.02 ist nicht der Durchschnitt über beide Gruppen, sondern der Schlaf-Effekt in der Referenzgruppe (KG, da alphabetisch erste Gruppe). Ebenfalls falsch: Der Wert −0.52 zeigt keinen negativen Zusammenhang in der Stressgruppe — er ist die Differenz der Steigungen (Stress vs. KG). Der Effekt in der Stressgruppe beträgt 2.02 − 0.52 = 1.50 und bleibt positiv, nur schwächer. Falsch ist ausserdem: Centering verändert nur den Intercept und die Haupteffekte der zentrierten Variablen (S12 F17); der Interaktionskoeffizient bleibt identisch.
Sie führen eine einfache Regression für Projektfrage Q2 („Sagt Schlafdauer die WM-Leistung vorher?“) durch und erhalten folgenden summary()-Output:
modell <- lm(wm_score_t2 ~ sleep_hours_t2, data = wm_daten)
summary(modell)
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 42.31 6.14 6.89 <.001 ***
sleep_hours_t2 2.41 0.82 2.94 .004 **
---
Residual standard error: 11.8 on 98 degrees of freedom
Multiple R-squared: 0.081, Adjusted R-squared: 0.072Welche Aussagen zur Interpretation dieses Outputs sind korrekt?
Der Koeffizient Estimate = 2.41 für sleep_hours_t2 beschreibt die Steigung: Pro zusätzliche Stunde Schlaf steigt der WM-Score im Schnitt um 2.41 Punkte. R² = .081 bedeutet, dass 8.1% der Varianz durch Schlaf allein erklärt werden — in der Psychologie ein plausibler Wert für einen einzelnen Prädiktor. Der Intercept (42.31) ist der vorhergesagte WM-Wert bei sleep_hours_t2 = 0 — inhaltlich nicht sinnvoll, aber mathematisch notwendig; Centering des Schlaf-Prädiktors (S12 F17) würde den Intercept sinnvoller interpretierbar machen. Falsch ist hingegen: Der Standardfehler (Std. Error = 0.82) ist nicht die Streuung der Variable Schlafdauer, sondern die Unsicherheit der Schätzung des Koeffizienten — er zeigt, wie präzise der Wert 2.41 geschätzt wurde.
TipBonus: Interaktionsmodell mit Zentrierung