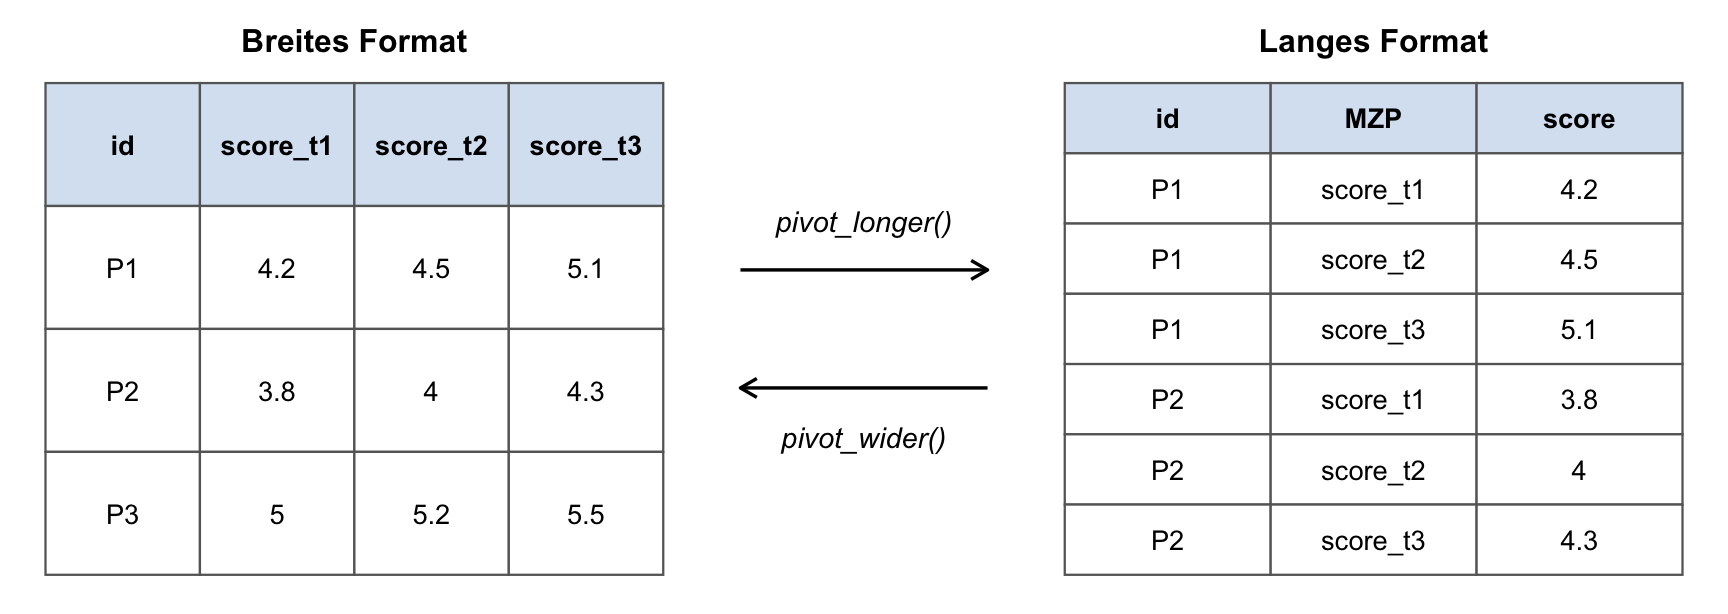
pivot_longer() dreht Spalten in Zeilen; pivot_wider() macht das Gegenteil.
FS 2026
In dieser Übung beschäftigen wir uns mit zwei grundlegenden Schritten der Datenaufbereitung: der Herstellung einer einheitlichen Datenstruktur nach dem Tidy-Data-Prinzip und der Umkodierung von Variablen, damit Werte inhaltlich konsistent und interpretierbar sind.
In Übung 3 haben Sie die beiden Datensätze WM_Fragebögen.csv und Lab_Kodierung.dat importiert und auf Plausibilität geprüft. In dieser Übung greifen wir darauf zurück und bringen die Daten in eine analysefähige Struktur.
Wenn Sie die Inhalte der Vorlesung nochmal vertiefen wollen, empfehle ich Ihnen folgende Videos:
Ein Datensatz ist tidy wenn:
Häufige Verletzungen:
score_t1, score_t2, score_t3)"KG_m" für Gruppe und Geschlecht)Das folgende Schema zeigt den Wechsel zwischen den beiden Formaten. Im breiten Format enthalten die Spaltennamen (score_t1, score_t2, score_t3) eine Information — nämlich den Messzeitpunkt. Im langen Format wird diese Information in eine eigene Spalte (MZP) ausgelagert. Die Umwandlung erfolgt mit pivot_longer() (breit → lang) bzw. pivot_wider() (lang → breit).
pivot_longer() dreht Spalten in Zeilen; pivot_wider() macht das Gegenteil.
| Ziel | Funktion |
|---|---|
| Breites → langes Format | pivot_longer() |
| Langes → breites Format | pivot_wider() |
Auch wenn die Struktur stimmt, können die Werte inhaltlich problematisch sein. Typische Situationen:
"KG", "Kontrolle" und "control" meinen dasselbe — R sieht drei verschiedene Gruppen"fehlend", "k.A." oder "keine Angabe" statt NADiagnostik vor der Umkodierung: Bevor man umkodiert, muss man wissen, was überhaupt vorhanden ist. Dafür eignen sich:
table(datensatz$variable)    # zählt alle Ausprägungen
unique(datensatz$variable)   # listet einmalige Werte auf
Umkodierungsfunktionen aus dem dplyr-Paket:
mutate() — erzeugt eine neue oder veränderte Spalte (Grundfunktion für alle Transformationen)case_when() — weist verschiedenen Bedingungen unterschiedliche Werte zu (flexibel, auch für viele Kategorien)recode() — direkte 1:1-Umbenennung von Werten (einfacher, aber weniger flexibel)Beispiel mit case_when():
datensatz <- datensatz |>
  mutate(gruppe_clean = case_when(
    gruppe_raw %in% c("KG", "Kontrolle", "control") ~ "KG",
    gruppe_raw == "EG"                               ~ "EG",
    .default = NA_character_
  ))
Tipp: Mit stringr-Funktionen wie str_remove() lassen sich Zeichenketten bereinigen, z. B. wenn eine Variable einen Wert wie "1/4" enthält und nur die Zahl 1 gebraucht wird.
Beantworten Sie die folgenden Fragen zu Tidy Data und Umkodierung.
Wie in den Übungen finden Sie unter den Übungsfragen die webr Konsole, die Ihnen das Schreiben und Durchführen von R Code direkt auf der Website ermöglicht. Wenn viele Studierenden die Übungen parallel machen, dann kann es sein, dass webr langsam wird.
Um den Code den Sie geschrieben haben auszuführen drücken Sie entweder
Run Code, damit der gesamte Code ausgeführt wird. Alternativ können Sie auch einzelne Zeilen ausführen, indem sie CTRL+Enter (Windows) oder CMD+Enter (Mac) drücken.
Sie haben einen Datensatz mit den Spalten id, score_t1, score_t2 und score_t3. Die drei Spalten enthalten jeweils Messwerte zu einem anderen Zeitpunkt. Welche Funktion aus dem tidyr-Paket bringt diesen Datensatz in das Tidy-Data-Format?
Korrekt ist pivot_longer(). Die Spalten score_t1, score_t2 und score_t3 verletzen das Tidy-Data-Prinzip, weil ihre Namen Werte (Zeitpunkte) und keine Variablennamen sind. pivot_longer() löst dieses Problem: Es erzeugt eine neue Variable zeitpunkt und eine neue Variable score, sodass jede Zeile genau eine Messung enthält. pivot_wider() macht das Gegenteil: es wandelt langes in breites Format um. full_join() führt zwei Datensätze zusammen. select() wählt Spalten aus und ändert die Struktur nicht.
In Ihrem Datensatz enthält die Variable gruppe die Werte "KG", "Kontrolle" und "control" — alle meinen dieselbe Kontrollbedingung. Welche der folgenden Aussagen zu diesem Problem und seiner Lösung sind korrekt?
Korrekt sind die Aussagen zur inkonsistenten Kodierung, zu case_when() als Lösung, und zur Verzerrung von Analysen. Wenn dieselbe inhaltliche Kategorie durch verschiedene Werte repräsentiert wird ("KG", "Kontrolle", "control"), spricht man von einer inkonsistenten Kodierung. R behandelt diese drei Werte als separate Gruppen — das verzerrt Zusammenfassungen, Gruppenvergleiche und alle darauf aufbauenden Analysen. Mit case_when() lassen sich alle drei Varianten einer einheitlichen Kodierung zuweisen. pivot_longer() verändert die Struktur des Datensatzes, behebt aber keine inhaltlichen Kodierungsprobleme.
Welche der folgenden Aussagen beschreiben das Tidy-Data-Prinzip korrekt?
Korrekt sind die Aussagen zu Variablen als Spalten und Beobachtungen als Zeilen. Tidy Data definiert eine klare Struktur: eine Variable = eine Spalte, eine Beobachtung = eine Zeile. Fehlende Werte werden durch Tidy Data nicht automatisch entfernt — sie bleiben als NA erhalten und müssen separat behandelt werden. Tidy Data macht keine Anforderungen an den Datentyp: Spalten können numerisch, kategorisch oder als Text vorliegen.
Nutzen Sie eine Suchmaschine, wenn Sie nicht wissen welche Funktionen Ihnen ein bestimmtes Ergebnis liefern.