Übung 8 - Datenvisualisierung I: Grammar of Graphics & Verteilungen
FS 2026
Grammar of Graphics: Eine Grafik wächst in Schichten
In dieser Übung geht es nicht um das Auswendiglernen von Funktionen, sondern um die Logik hinter ggplot2: Eine Grafik ist ein Satz aus Entscheidungen — jede Schicht beantwortet eine Frage.
Die fünf Schichten
- Daten (
ggplot(data = ...)): Welcher Datensatz? - Mapping (
aes(x = ..., y = ..., fill = ...)): Welche Variable → welche visuelle Eigenschaft? - Geometrie (
+ geom_xxx()): Welche Form (Punkte, Balken, Boxplot, Histogramm)? - Beschriftung (
+ labs(...)): Titel, Achsenbeschriftung, Einheiten. - Theme (
+ theme_minimal()): Erscheinungsbild — was, nicht wie.
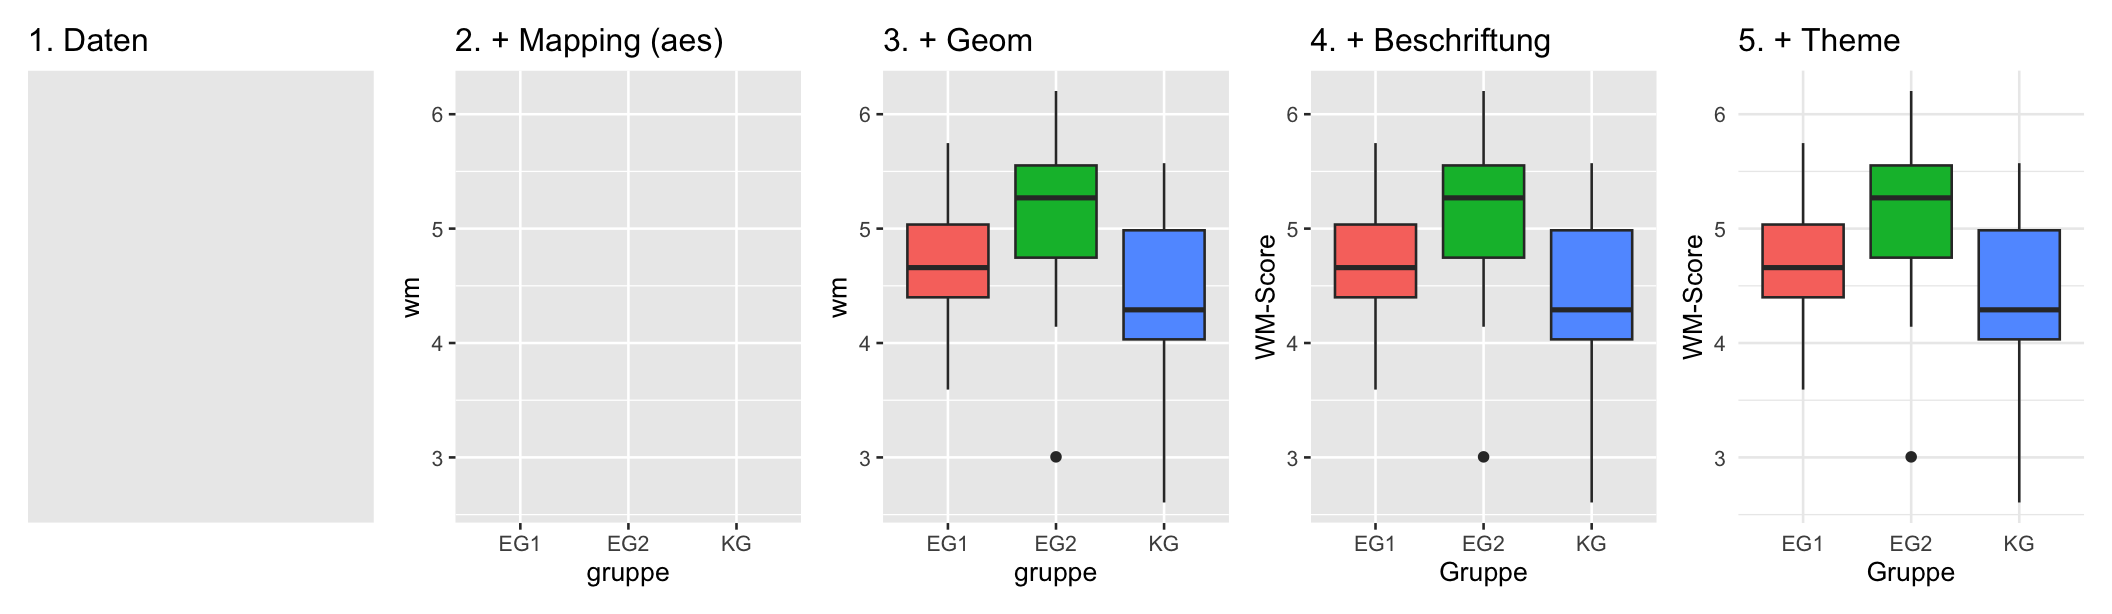
Die folgende Abbildung zeigt, wie dieselbe Grafik Schicht für Schicht entsteht: Jeder Schritt fügt genau eine Entscheidung hinzu und verändert nur das, was diese Schicht steuert.
Aesthetics: mehr als nur x und y
Mit aes() bilden Sie Variablen auf visuelle Eigenschaften ab — x, y, color, fill, shape. Wichtig: Eine Aesthetic, die von einer Variable abhängt, gehört innerhalb von aes(). Ein fester Wert (z. B. alle Punkte blau) gehört ausserhalb:
# Variable steuert Farbe → innerhalb aes()
ggplot(daten, aes(x = gruppe, y = wm_score_t1, fill = gruppe)) + geom_boxplot()

# Feste Farbe für alle → ausserhalb aes()
ggplot(daten, aes(x = gruppe, y = wm_score_t1)) + geom_boxplot(fill = "steelblue")
Verteilungen sichtbar machen
Kennwerte wie Mittelwert und SD komprimieren Daten auf wenige Zahlen und verschweigen die Form der Verteilung. Anscombe’s Quartett und bimodale Verteilungen zeigen: identische Kennwerte können sehr unterschiedliche Datenbilder erzeugen. Darum kombinieren wir mehrere Schichten.
Drei Blickwinkel auf eine Verteilung
| Geom | Was es zeigt | Grenze |
|---|---|---|
geom_histogram() |
Häufigkeiten in Bins | Bin-abhängig |
geom_density() |
geglättete Verteilung | glättet Bimodalität weg |
geom_jitter() |
jede Beobachtung einzeln | unübersichtlich bei grossem N |
stat_summary(): Zusammenfassung als eigene Schicht
Mit stat_summary() lässt ggplot Daten erst zusammenfassen und dann darstellen:
stat_summary(fun = mean, geom = "point")→ ein Punkt pro Gruppe (Mittelwert).stat_summary(fun.data = mean_cl_normal, geom = "pointrange")→ Mittelwert + 95%-Konfidenzintervall.
Das CI zeigt die Präzision der Mittelwertsschätzung, nicht die Streuung der Einzelwerte. Überlappende CIs bedeuten nicht automatisch „kein Unterschied” — das ist Thema in Übung 11 (ANOVA).
Kombinierter Plot: drei Schichten in einem Bild
Boxplot (Kennwerte), Jitter (Rohdaten), stat_summary (Schätzung + Unsicherheit) liefern gemeinsam ein vollständiges Verteilungsbild. Mit position_nudge(x = ...) verschieben wir die einzelnen Schichten sauber nebeneinander:
ggplot(daten, aes(x = gruppe, y = wm_score_t1)) +
  geom_boxplot(width = 0.15, position = position_nudge(x = -0.2)) +
  geom_jitter(width = 0.08, alpha = 0.5) +
  stat_summary(fun.data = mean_cl_normal, geom = "pointrange",
               color = "red", position = position_nudge(x = 0.2))
Übungen
Beantworten Sie zunächst die folgenden Fragen zur Logik von ggplot2 und zur Interpretation kombinierter Verteilungsplots.
In einem Diagramm werden Mittelwerte mit 95%-Konfidenzintervallen (CI) dargestellt. Die CIs zweier Gruppen überlappen sich leicht. Welche Aussagen sind korrekt?
Eine leichte Überlappung der CIs bedeutet nicht automatisch, dass kein signifikanter Unterschied vorliegt — tatsächlich kann bei ca. 50% Überlappung der Unterschied durchaus signifikant sein. Ein statistischer Test ist zur Beurteilung nötig. Ein Konfidenzintervall beschreibt die Präzision der Schätzung des Populationsmittelwerts, nicht die Streuung der Einzelwerte. Falsch ist die Aussage, dass CIs den Bereich zeigen, in dem 95% der Messwerte liegen — das wäre ein Vorhersageintervall, nicht ein Konfidenzintervall.
Welche Aussagen zur Logik von ggplot2 (Grammar of Graphics) sind korrekt?
ggplot2 basiert auf dem Schichtprinzip (Grammar of Graphics): Daten werden über Aesthetics (aes()) auf visuelle Eigenschaften abgebildet, und Geome bestimmen die geometrische Darstellung (z. B. Punkte, Balken, Boxplot). Falsch ist, dass ggplot2 automatisch Variablen zuordnet — die Zuordnung muss explizit über aes() definiert werden. Ebenso falsch ist, dass nur ein Geom pro Plot möglich sei: ggplot2 erlaubt beliebig viele Schichten (z. B. Punkte und eine Regressionslinie im selben Diagramm).
Eine Grafik kombiniert drei Schichten: einen Boxplot (links versetzt), eine Punktewolke (geom_jitter() in der Mitte) und einen Mittelwert mit 95%-Konfidenzintervall (stat_summary(fun.data = mean_cl_normal, ...), rechts versetzt). Welche Aussagen zu den Informationen der einzelnen Schichten sind korrekt?
Der kombinierte Plot macht drei komplementäre Informationen gleichzeitig sichtbar. Der Boxplot bündelt die Verteilung auf fünf robuste Kennwerte — er ist kompakt und vergleichbar, verdeckt aber die Form der Verteilung (bimodale oder schiefe Verteilungen können hinter ähnlichen Boxplots stecken). Die Punktewolke ergänzt das, indem sie jede Beobachtung zeigt — Stichprobengrösse, Ausreisser und Verteilungsform werden direkt sichtbar. Das Konfidenzintervall aus stat_summary() beschreibt jedoch die Präzision der Schätzung des Mittelwerts, nicht die Streuung der Einzelwerte — die dritte Aussage ist deshalb falsch (das wäre ein Vorhersageintervall). Die vierte Aussage ist korrekt: Wenn Median und Mittelwert sichtbar auseinanderliegen, deutet das auf Schiefe hin — einer der Gründe, beide Kennwerte in einem Plot zu zeigen.
Welche der folgenden Aussagen zum Umgang mit Aesthetics in ggplot2 sind korrekt?
Aesthetics, die von einer Variable abhängen, müssen innerhalb von aes(...) stehen — nur dann koppelt ggplot2 die visuelle Eigenschaft an Werte der Variable. Feste Werte (z. B. einheitliche Farbe) stehen ausserhalb von aes(...). Die zweite Aussage ist deshalb falsch: aes(color = "blue") würde "blue" als kategoriale Variable interpretieren und eine (unsinnige) Legende erzeugen; korrekt wäre geom_point(color = "blue"). Die Aussage zu shape ist richtig — Symbolformen sind nützlich, wenn Farbe nicht verfügbar ist oder die Grafik schwarz-weiss reproduziert wird. Ebenso korrekt ist, dass sich die Wahl zwischen fill (Fläche) und color (Linie/Rand) nach der Geometrie richtet: Boxplots haben Flächen (fill), Histogramm-Linien oder Scatter-Punkte werden über color eingefärbt.
Praktische Aufgabe: Drei Plots, drei Datenformate
Die folgenden Aufgaben greifen die Logik aus der Vorlesung auf: unterschiedliche Plottypen benötigen unterschiedliche Datenformate. Histogramm und Boxplot mit Messzeitpunkt als Aesthetic brauchen das Long-Format (df_plot); das Streudiagramm mit T1 × T2 auf zwei Achsen braucht das Wide-Format (df_analyse).
TipWeiter vertiefen
Diagrammtyp-Auswahl, irreführende Grafiken, Facettierung, Farbskalen und publikationsreife Grafiken finden Sie in Übung 9 (Selbststudium).